Analiza częstości liter
W każdym języku litery mają charakterystyczną częstość. Szyfr podstawieniowy zmienia symbole, ale nie ich rozkład — porównaj histogramy i złam szyfr.
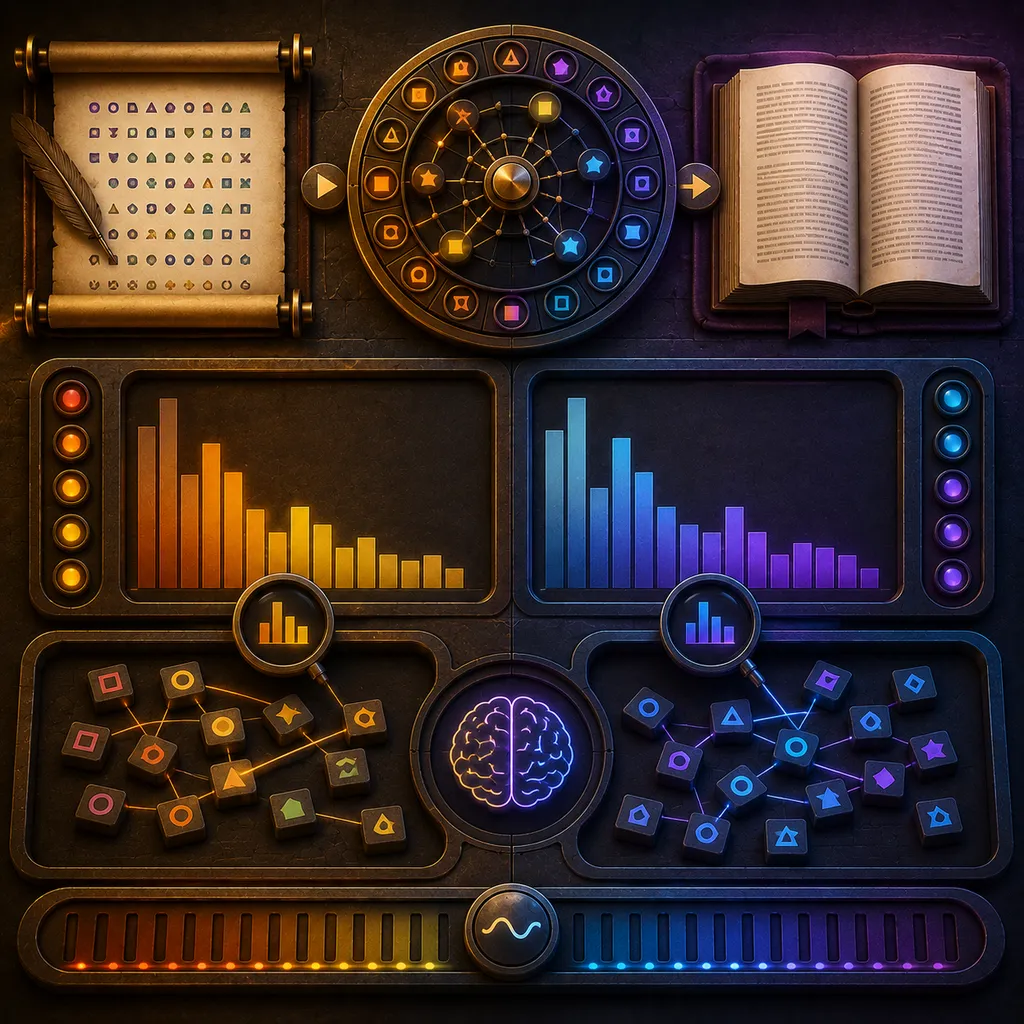
Dam Ci język — wskaż jego najczęstszą literę. To ona zdradza podstawienie w kryptoanalizie.
O co tu chodzi?
W każdym języku litery pojawiają się ze stałą, charakterystyczną częstością. W polskim najczęstsze są A, I, O, E, w angielskim E, T, A. Ta „sygnatura" języka jest bardzo trwała — wystarczy kilkaset znaków, by się ujawniła.
Częstość względna litery:
gdzie to liczba wystąpień litery, a — łączna liczba liter w tekście. Zbiór wartości to właśnie rozkład częstości, który rysujemy jako histogram.
Dlaczego to łamie szyfr podstawieniowy?
Szyfr podstawieniowy zastępuje każdą literę innym stałym symbolem (tu: przesunięcie o pozycji). To tylko zmiana etykiet — litera przypisana do symbolu wciąż występuje tak samo często:
Dlatego histogram szyfrogramu ma dokładnie ten sam kształt, co histogram tekstu jawnego — jest tylko przesunięty i przemianowany. Najczęstszy symbol szyfrogramu prawie na pewno odpowiada najczęstszej literze języka. Dopasowanie najwyższych słupków ujawnia podstawienie.
Niezmiennik:
Podstawienie zachowuje rozkład częstości — zmienia jedynie nazwy symboli. Kształt histogramu jest niezmienniczy względem podstawienia, i to on, a nie długość tekstu, zdradza szyfr.
Odrobina historii:
Analizę częstości opisał już w IX wieku arabski uczony al-Kindi w traktacie o odczytywaniu zaszyfrowanych wiadomości — to pierwszy znany opis kryptoanalizy. Ta sama idea złamała później słynny szyfr Vigenère’a i wciąż stanowi fundament kryptoanalizy klasycznej.
Po co Ci to na maturze:
Analiza częstości to sztandarowy przykład, że informacja może „przeciekać" nawet przez pozornie bezpieczny szyfr. Chwyt: szukaj tego, co przekształcenie zostawia bez zmian — niezmiennika. Tu jest nim rozkład częstości.
Zapamiętaj: podstawienie miesza etykiety, ale nie częstości — najczęstszy symbol szyfru to najczęstsza litera języka.
Teoria i wzory
Zasada
Szyfr podstawieniowy zamienia każdą literę na inną według stałego przyporządkowania, ale nie zmienia częstości jej występowania. Histogram częstości zostaje — zmieniają się tylko etykiety symboli.
Łamanie szyfru
Najczęstszy symbol szyfrogramu odpowiada najczęstszej literze języka (w polskim i angielskim zwykle samogłoski). Dopasowując rozkłady, odtwarzamy przyporządkowanie liter.
Wniosek
Nawet ogromna przestrzeń kluczy (dla liter aż ) nie chroni, jeśli przez szyfr „prześwieca” statystyka tekstu.
Oznaczenia: liczba możliwych podstawień alfabetu.
Uczysz? Umieść ten eksperyment na swojej stronie.
Darmowy widget — wklej na stronę szkoły, bloga lub notatki. Linkuje do pełnej wersji.
Najczęstsze pytania
›Jak łamie się szyfr podstawieniowy?
Analizując częstość symboli — najczęstszy w szyfrogramie odpowiada najczęstszej literze języka.
›Dlaczego to działa?
Bo podstawienie zmienia tylko etykiety symboli, nie zmienia kształtu rozkładu częstości.
Powiązane eksperymenty